-
实测海外cdn免费的加速效果与稳定性案例展示
2026/5/23 -
游戏服务器怎么样cdn加速 的技术评估与可行性分析报告
2026/5/6 -
法律视角解读未备案 cdn加速对企业运营的潜在合规隐患
2026/8/14 -
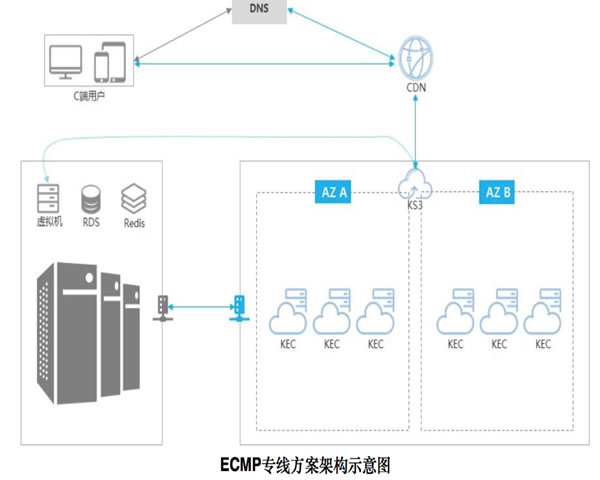
cdn游戏应用 在移动端与端游场景下的落地实践总结
2026/5/15 -
为企业推荐几家口碑好的快速cdn证办理网站对比分析
2026/3/8 -
优质海外cdn与本地运营商合作带来的跨境传输优化案例
2026/7/2
从运维角度看杨哥海外cdn的故障恢复与监控体系建设
1. 背景与目标
目的:建立可观测、可自动切换、可演练的海外CDN故障恢复体系。
范围:覆盖POP可用性、回源链路、DNS解析、证书与缓存一致性。
目标度量:RTO(恢复时间)≤5分钟,RPO(数据丢失)可忽略。
2. 架构与组件清单
列出组件:CDN节点(POP)、回源(Origin)、DNS(权威/二级)、监控(Prometheus/Grafana)、合规探测(Synthetic)。
依赖清单:BGP、Anycast、证书管理、日志收集(ELK/EFK)。
3. 监控指标与数据采集
关键指标:POP可用率(PopUp)、回源延迟、4xx/5xx比例、缓存命中率、TLS握手失败率。
采集实现:在边缘注入探针,使用Prometheus node_exporter + blackbox_exporter做HTTP/TCP合成检查,日志通过Filebeat上报。
4. 告警策略与分级
一级告警(立即推送):POP全部不可达、回源超时、证书失效。二级告警(邮件/工单):缓存命中下降>30%、延迟上升>200ms。
告警抑制:利用Alertmanager抑制波动告警并设置重复间隔与抑制规则。
5. 故障检测到响应的Runbook(详细步骤)
步骤1-检测:查看Prometheus面板,定位异常POP;运行blackbox的curl探测:curl -vk https://域名 --resolve。
步骤2-隔离:通过CDN控制台将异常POP下线或降低权重;API示例:POST /api/v1/pop/{id}/disable。
步骤3-切换回源:若回源故障,修改CDN回源配置至备份Origin(API或控制台),并触发缓存预热。
步骤4-回滚与确认:问题解决后,按顺序逐POP上线,监控60分钟无异常再完全恢复流量。
6. DNS与流量切换详细操作
准备:将域名TTL设为短周期(60s)以便切换。
切换流程:1) 在权威DNS添加备份CNAME或A记录;2) 通过API分阶段降低主CDN流量权重;3) 验证全球解析:使用dig + HTTP探测确认生效。
回退:恢复TTL为正常值并清理临时记录。
7. 自动化与演练
自动化脚本:使用Terraform+CDN厂商API管理配置,编写一个故障演练脚本(shell/python)模拟POP下线并验证切换。
演练频率:每月一次全量演练,演练步骤要记录RTO、误报与改进项写入SOP。
8. 问:当某个海外POP在凌晨突然全部不可达,应如何快速恢复流量?
答:第一时间执行Runbook:1) 在控制台或通过API将该POP下线或权重设为0;2) 确认DNS TTL短时间内会把流量导向其他POP;3) 若是回源问题同时启用备份Origin并触发缓存预热;4) 通过合成监控确认端到端可用性;5) 记录事件并在事件结束后进行根因分析。
9. 问:如何避免DNS缓存导致切换延迟?
答:预防措施:将关键域名的TTL在变更窗口前下调到60秒;使用全球多个权威DNS节点;在切换完成并稳定后再提升TTL。实践中可通过脚本在切换前自动修改TTL并在稳定后恢复。
10. 问:监控平台报警频繁抖动,上线后如何优化?
答:优化步骤:1) 增加告警抑制与分级,避免短时波动触发一级告警;2) 调整采集间隔与滑动窗口(例如5分钟平均)减少噪声;3) 为重要指标建立异常检测模型(如Prometheus的recording rule或外部机器学习告警);4) 定期回顾告警,移除无效告警并完善Runbook。